С чего начать исследование? От исследовательского вопроса к дизайну исследования
Доклад, Форум Инновационная онкология, Москва, РФ
После диалогов на РОКе коллеги-онкологи предложили провести аналогичную на форуме Инновационная онкология, отдав ее практически полностью на откуп мне (формат, темы, модерация) – помогли только с подбором почти всех спикеров со стороны клиницистов. Я, конечно, сразу решила, что это будет не баттл, а 4 мини-диалога, в каждом из которых клиницист задаст свои вопросы по какой-то теме, а статистик постарается на них ответить. И да, как и в прошлый раз, предполагалось, что клиницисты сформулируют свои вопросы заранее, чтобы от этих диалогов было больше пользы для них же самих.
Совместно с коллегами-статистиками сформулировали 4 темы:
С чего начать исследование? От исследовательского вопроса к дизайну исследования
Изначально была мысль поговорить о разных дизайнах исследований, поскольку из общения с аспирантами, ординаторами и даже более опытными исследователями у меня сложилось ощущение, что все дизайны они делят на РКИ и “ретроспективные”, а про случай-контроль и вообще никогда не слышали.
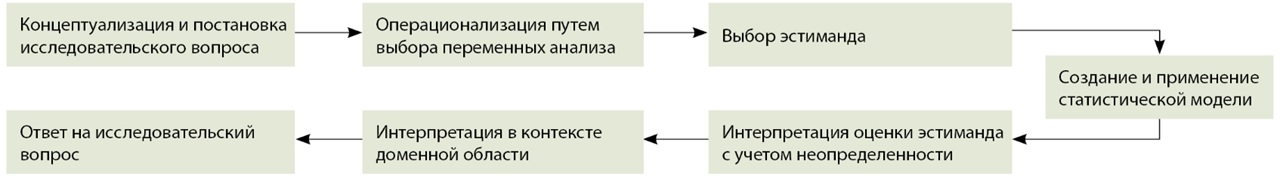
Но аккурат на финальном этапе подготовки моей презентации была опубликована наша с коллегами статья, первая из запланированного цикла по статистическим мифам – и в ней мы, в том числе, представили наше видение места статистического анализа в процессе научного поиска (см. рисунок выше). И тут меня осенило, что вот ведь оно – то, о чем можно рассказать в своем докладе: концептуализация исследовательского вопроса, операционализация и описание эстиманда. Это ровно то, что предшествует выбору дизайна, методологии анализа и формулировке требований к сбору данных, не говоря уже непосредственно о расчете объема выборки или самом статистическом анализе.
Это озарение помогло понять, почему у моей пары, Мириам Манукян, возникли сложности в формулировке вопросов для нашего диалога: это просто такие этапы работы над исследованием, когда у статистика должно быть больше вопросов к клиницисту, чем наоборот. Возможно, если бы у нас с коллегой-онкологом было больше времени на подготовку, получилось бы на конкретных примерах разобрать, какой в каждом исследовании на самом деле был эстиманд, как это отразилось на особенностях дизайна исследования и методах анализа, и понять, получилось ли ответить исследователям именно на тот вопрос, который их интересовал, или, как это часто бывает, какое-то неявное допущение завело их куда-то не туда.
В своем докладе я задавала залу 2 вопроса: кто хотя бы раз слышал слово “эстиманд” и кто хотя бы примерно знает, что это такое. Леса рук, конечно, не было, но их было даже меньше, чем я ожидала. Коллеги-статистики после конференции предложили как-нибудь тему эстимандов обсудить более подробно – и я буду рада, если получится. Пост про эстиманды для задач ОТЗ у меня уже давно в плане висит. Что касается клиницистов, то, в принципе, их незнакомство с термином “эстиманд” вполне понятно: в статьях с результатами исследований его редко встретишь, но, в общем-то, когда исследователи обсуждают, например, на каком-нибудь журнальном клубе, каких пациентов включали в исследование, как было устроено воздействие, был ли кроссовер и как он учитывался в анализе, по каким причинам пациенты прекращали терапию или выбывали из исследования досрочно, как сравнивались группы и т.п., фактически они и пытаются выяснить, что из себя представлял эстиманд в этом исследовании. Статистики просто придумали одно емкое слово, чтобы назвать им точный объект оценивания в исследовании. И да, более полное описание эстимандов помогло бы не только при планировании исследований, но и при интерпретации опубликованных результатов.
Хватит ли нам пациентов? Мощность и размер выборки в проспективных и ретроспективных исследованиях
- Тут мне очень понравился доклад со стороны онкологов – что называется, почувствуй боль исследователя, особенно аспиранта, когда Экспертный совет требует запланировать объем выборки, научный руководитель отправляет искать пациентов в базе, штатного статистика в учреждении нет, калькулятор выдает безуемное количество пациентов, а статистические статьи пугают страшными формулами.
- Алексей Глазков постарался ответить на некоторые из вопросов, которые ему задал Сергей Сергеевич Гордеев, но вопросов было столько, что за отведенное время это было сделать невозможно, да и решать такие вопросы всегда лучше в привязке к конкретной задаче.
- Так, как правильно отметил Алексей, для ретроспективных исследований, когда численность пациентов задана объективными ограничениями, лучше прикинуть, какой размер эффекта при этом объеме выборки можно будет счесть статистически значимым, и принимать решение о целесообразности исследования, исходя из этого. Я бы тут добавила, что лично мне не нравится деление научных исследований на успешные/ позтивные и неуспешные/ негативные в зависимости от того, был ли в нем результат статистически значимым, как и излишнее педалирование темы проверки статистических гипотез. Корректное планирование исследований, которое не сводится исключительно к расчету объема выборки, применение статистических инструментов, интерпретация полученных результатов с клинической точки зрения, уже заслуживает высокой оценки. А для общего пула знаний по проблеме статистически незначимые результаты тоже важны, как и недостаточно одного статистически значимого результата.
- Еще один момент, на который Алексей обратил внимание, – это отношение к последовательным дизайнам как к решению проблемы небольшого числа пациентов или событий, доступных для анализа: если повезет и эффект окажется больше, чем предполагалось, то получится остановиться раньше и обойтись меньшим числом пациентов, а если не повезет, то потребуется больше времени и пациентов, чем в одностадийном дизайне. Плюс, в первом случае всегда есть риск того, что статистически значимый результат в небольшом, маломощном исследовании даст завышенную оценку эффекта.
Что делать, если рандомизации нет? Подходы к оценке причинного эффекта в наблюдательных исследованиях
Яркое выступление Олеси Кузнецовой со стороны клиницистов, в котором она обратила внимание на то, что, с одной стороны, исследования по данным реальной клинической практики или клинические исследования без рандомизации очень востребованы для оценки эффективности терапии для более широкой популяции пациентов или для орфанных заболеваний, а с другой, статистика FDA свидетельсвует о том, что в ряде случаев после регистрации препаратов на основе подобных исследований и получения дополнительных данных появляются основания для отзыва препаратов с рынка, для отмены регистрации. На мой взгляд, это вопрос не только различий между целевой популяцией и той, которая попала в регистрационное исследование, но и как раз возможной переоценки эффекта на малых выборках.
Доклад Никиты Бурлова был, пожалуй, самым сложным из всех: он рассказал не только про основы причинно-следственного вывода (про причинно-следственные графы и конфаундинг), но и про методы работы как с наблюдаемыми, так и с ненаблюдаемыми конфаундерами. Последнее, конечно, очень интересно и очень востребовано в биомедицинских исследованиях, но те методы, которые сейчас существуют для решения подобных задач (разность разностей, разрывный дизайн, инструментальные переменные), на мой взгляд, в силу своих допущений, имеют довольно ограниченное применение в этой сфере. Если, конечно, не считать рандомизацию, которая, по сути, является реализацией метода инструментальных переменных. Эконометристы, которым, наоброт, рандомизация воздействия обычно не доступна, но которые чаще имеют дело с оценкой эффективности различных программ, охватывающих не всю целевую популяцию, и разработали перечисленные методы. Возможно, как раз в исследованиях в области ОТЗ и доступа на рынок такие методы найдут более широкое применение, чем на биомедицинском “микроуровне” (в клинических или наблюдательных научных исследованиях). В конце концов в NICE TSD 17 они упоминаются.
Можно ли доверить исследование ИИ? Возможности и ограничения ИИ при планировании и анализе исследований
Самая живая часть, несмотря на то, что мы поставили ее в конце и за полтора с лишним часа с начала сессии многие уже порядком устали. И, благодаря обоим спикерам, Владимиру Евдокимову и Кириллу Воронину, это действительно получился настоящий диалог, когда первый задал интересующие его вопросы, а второй последовательно на них ответил. Я точно знаю, что у них было совсем немного времени на подготову, но они использовали его максимально эффективно и мне очень понравилось, что у них получилось наладить диалог заранее и подготовиться к докладам вместе.
Конечно, ИИ пока не заменит статистика, да и клинициста, да и вообще естественный интеллект. И общение с ИИ не заменит живого диалога между клиницистом и статистиком. Но, по себе знаю, что он может помочь к этому диалогу подготовиться, – одна из полезных, на мой взгляд, рекомендаций от Кирилла. Да, общаться с ИИ может быть комфортнее, чем с
вреднымживым статистиком: ИИ не будет вас критиковать, встанет на вашу сторону, найдет аргументы за или против любой точки зрения и будет при этом очень убедительным, но за всем этим человеку, недостаточно погруженному в статистику, может быть сложно заметить ошибки и неточности, тем более что на один и тот же вопрос в нескольких обращениях ИИ может дать разные ответы, каждый новый раз признавая, что в прошлый он был неправ и прося у вас прощения. Надо дойти до ссылок на статьи в презентации Кирилла, в которых приводили примеры, что даже в расчете объема выборки при одних и тех же вводных (не самая сложная задача) ИИ может ошибиться не один раз.
Вместо постскриптума.
Красной нитью через все доклады клиницистов, кроме последнего, прошло упоминание рандомизированных несравнительных исследований (RNCT), которым был посвящен мой доклад в диалогах с клиницистами на РОКе в прошлом году. Это что, был такой флешмоб? Но я по поводу этого недодизайна уже все сказала в прошлом году, и за это время мое мнение не изменилось. Видимо, пока исследование будет начинаться с расчета объема выборки, а не четкого описания того, для чего на самом деле проводится исследование, как будут использоваться его результаты, что на самом деле необходимо будет оценить и для какой именно целевой популяции, эти “уговоры” будут продолжаться вместе с воспроизведением прочих статистических мифов, к числу которых в упомянутой выше статье я не забыла отнести и RNCT. Сама ты, Оля, вредина! (с)
Еще один момент, который показался мне общим во многих докладах, – клиницисты обычно приводят в пример РКИ и прочие исследования, которые проводят крупные фармкомпании, – ничего не имею против этого, но, на мой взгляд, научные исследования, особенно те, которые проводятся для защиты диссертации, – это сильно другое. Да, разбираться в том, как устроены и проводятся РКИ – это полезно (все-таки, “эталон”, “золотой стандарт” “доказательной медицины”), но у аспиранта и врача-исследователя обычно не только другие ограничения, но и другие задачи (ближе к практике, к пациенту, ну или просто “защититься”), поэтому нужно учиться их формулировать, переводить на статистический язык и обратно с учетом их специфики. Если нужна только “корочка”, то статистика превращается просто в ритуал, и тогда обращаться к статистику за советом – это как прийти к врачу за рецептом на то, что вы уже сами себе прописали. А если нужно “по науке и для науки”, тогда нужно быть готовым к тому, что путь будет непростым, но зато хотя бы интересным и полезным всем (надеюсь!) сторонам этого диалога.
Чтобы не заканчивать на этой сложной ноте, подблагодарю всех коллег, и статистиков, и клиницистов, за участие в сессии, а организаторов – за ее добавление в сетку форума. Коллеги-статистики, которые смотрели онлайн-трансляцию, сказали, что им очень зашел такой формат “вопрос – ответ”. До встречи :)